大家好,我是 Ai 大模型本地部署的老章
常玩本地部署大模型的朋友,想必对一件事深恶痛绝:大模型经常陷入严重的“过度思考”
你让它写个简单的 Python 爬虫脚本,或者排查一行报错,它非要在 <think> 标签里自我感动地推演上万个 Token,连 Markdown 格式和开场白都要在脑子里反复琢磨好几遍,等得花儿都谢了
基座模型 Qwen3.8-27B 咱们之前拆解过多次,综合底子极其扎实,但我刚发现一个魔改混血怪物,名字长的不像话——Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF,直接把开源 27B 的战力拔到了令人发指的新高度
其实这个团队我直接就介绍过,他们在3.7-27B上已经玩出了圈:“最好”的Qwen3.6-27B版本,神级杰作,本地部署
Qwen3.8-TURBO-735 核心基准与完全体测试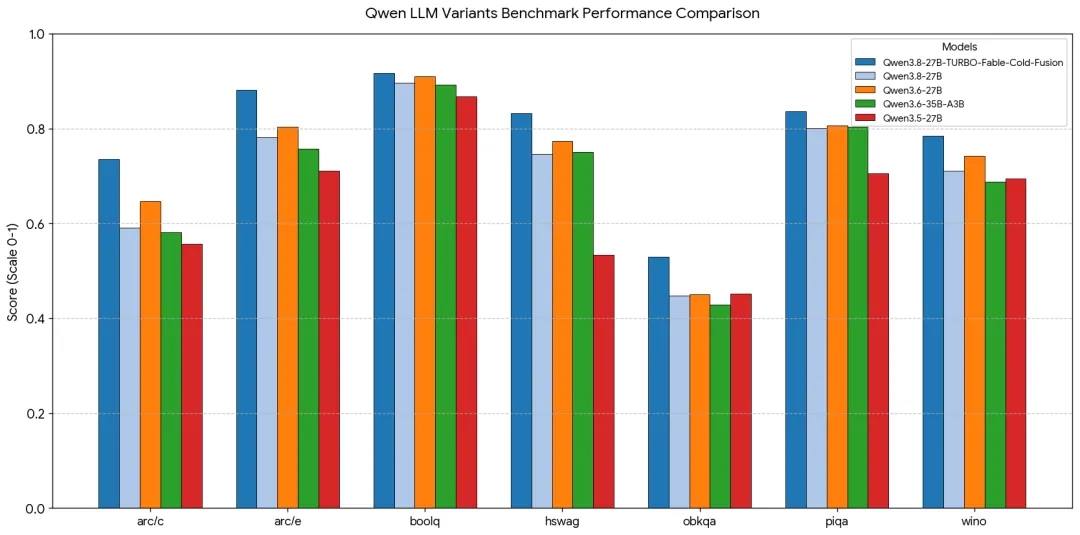
✦简介
这个模型名字长到一口气念不完,但每一个后缀都代表着极其暴力的工程改造
最震撼的核心指标:
在 8-bit 量化下,它的 ARC-C(复杂常识与科学推理基准)直接冲到了 735 分,比起原生 Qwen3.8-27B 足足暴涨了 144 分;哪怕砍到 4-bit 极限压缩,ARC-C 依然稳居 718 分;而 ARC-E 更是狂飙到了 882 分
了解大模型评测的朋友都很清楚,ARC-C 突破 700 分的“高智商俱乐部”,以往向来是 OpenAI、Claude 3.7/Opus 以及 Gemini 顶尖闭源模型的专属领地,如今一个能在单张民用显卡上跑得飞起的 27B 开源微调模型,硬生生把闭源豪强的大门踹开了
Qwen3.8-TURBO 架构级突围全景与核心技术流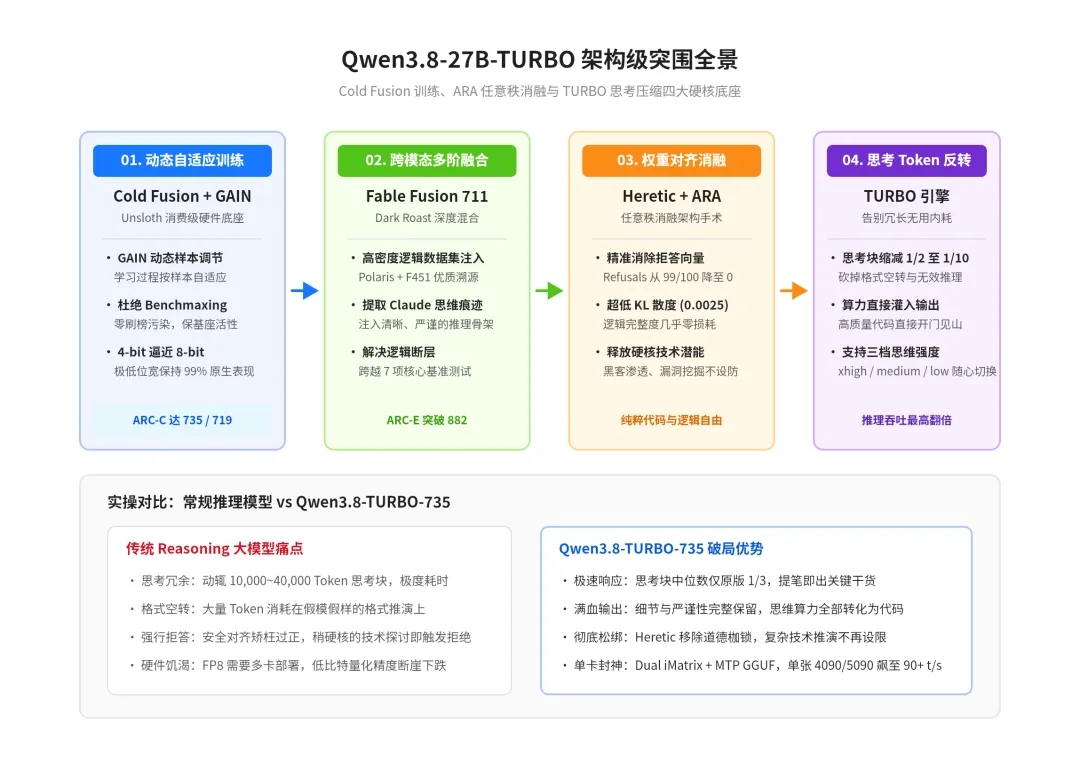
这货最狠的四大核心杀招:
TURBO 级思考瘦身
:思考 Token 暴砍 1/2 至 1/10,彻底终结格式空转和无病呻吟 Cold Fusion + GAIN 动态调度
:全程用 Unsloth 在消费级硬件上完成多阶段微调,零刷榜毒化,4-bit 保留 99% 的 8-bit 原生战力 Heretic + ARA 任意秩消融
:在正交权重空间动手术,拒答率从 99/100 砸到 0,KL 散度低至 0.0025,彻底解除道德绑架 Dual iMatrix + MTP GGUF
:双重重要性矩阵量化,支持多 Token 投机预测(MTP),单卡 4090/5090 吞吐轻松突破 90+ t/s
✦为什么叫 TURBO:把思考内耗反转为硬核输出
大家用传统 Reasoning 模型最头疼的地方,在于模型“想得多,吐得少”
常规 Qwen3.8-27B 面对问题往往要来回瞻前顾后,思考块动辄堆到 10k 到 40k Token;而这个 TURBO 版本直接反转了思考块与输出块的比例
作者团队的微调目标:砍掉格式推演与无效发散,把思考块的中位数压缩到原版的 1/3 甚至 1/10,直接将本该浪费在内部死循环上的算力,倾泻到最终的输出内容里
来看官方披露的一组实测对比:
当你问它“为什么选你来帮我做硬核技术写作”时,普通模型还在客套分析你的背景,它开屏就是一记重拳:
这股扑面而来的张力和速度感,就是 TURBO 风格的最佳写照
模型原生支持三档思考强度(xhigh、medium、low)
如果你在本地工具(如 LM Studio 或 KoboldCpp)里想进一步压榨速度,直接在 Jinja 模板顶部改一行配置即可随心切换:
如果遇到极其苛刻的高难度数学证明或底层逆向工程,只需在 Prompt 里加上一句扩展提示(比如“请仔细校验每个指针边界与汇编栈帧”),它就会自动调动深度思考,按需投入算力
✦Cold Fusion:消费级硬件上的多阶段炼丹奇迹
很多打着“高分”旗号的微调模型,往往是靠死记硬背 Benchmark 题库刷出来的“高分低能儿”,一到真实业务场景就原形毕露
这个模型走了一条截然不同的技术路线:COLD FUSION(冷融合)体系
主创团队联合 Nightmedia、TeichAI 等极客成员,先自研了名为 GAIN 的动态训练技术
普通微调的学习率在整个 Batch 中往往是僵化的,而 GAIN 能够动态根据每一个样本的学习状态,在训练过程中实时调整优化步长
最难能可贵的是,这套复杂的方案全程通过 Unsloth 框架,完全在民用消费级显卡上训练调通,狠狠打破了大厂对前沿微调的技术垄断
随后,团队引入 Fable Fusion 711 深度混合技术,融入了精选的 Polaris 数据集、F451 优质逻辑样本以及经过提纯的高质量推理痕迹,把模型解决复杂跨学科问题的逻辑链条焊死在权重里
七大核心基准测试的实测成绩单堪称离谱:
| ARC-C (科学推理) | 0.735 | +144 分 (史诗级跨越) | ||
| ARC-E (常识推理) | 0.882 | +100 分 | ||
| BoolQ (布尔质询) | 0.917 | |||
| HellaSwag (语境推理) | 0.832 | +86 分 | ||
| OpenBookQA | 0.530 | +82 分 | ||
| PIQA (物理常识) | 0.837 | |||
| WinoGrande | 0.785 | +74 分 |
全线飘红,没有任何一项指标出现倒挂
更让人安心的是在 4-bit 极限压缩下,ARC-C 依然高达 0.719,ARC-E 甚至跑出了 0.887,说明量化损失几乎被控制在了毫厘之间
✦Heretic + ARA:权重正交空间的精准手术
除了思考冗长,许多开发者日常使用开源模型时,最反感的就是无休止的“安全说教”与“误判拒答”
你分析个网安漏洞的 Shellcode,或者推导一段恶意代码的逆向防御逻辑,模型动不动就跳出一段道德长篇大论然后撂挑子
这个版本引入了开源社区极具创见的 Heretic 与 ARA(Arbitrary-Rank Ablation,任意秩消融) 技术
以往很多粗暴的“去审查”微调,往往会导致模型智商断崖式下跌(俗称“切除前额叶”)
而 ARA 技术直接深入 Transformer 权重的正交激活子空间,精准找出触发安全拒答的投影方向并执行定向消融
两阶段去对齐的消融数据非常说明问题:
超低的 KL 散度意味着它原汁原味继承了阿里通义团队对基础科学、代码世界和语言逻辑的庞大知识储备,消融掉的只是无谓的限制枷锁
对于做代码审计、自动化渗透测试、漏洞分析以及深层技术推演的极客而言,这才是真正趁手不添堵的工具
✦安装与部署实操
模型支持标准 ChatML 格式,无论是在工业级推理引擎(vLLM / SGLang)还是桌面端(LM Studio / Ollama / KoboldCpp),都能无缝拉起
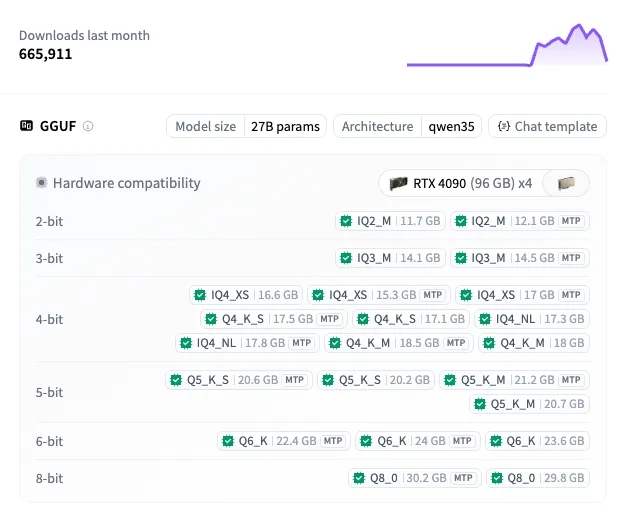
✦1. vLLM 高并发生产级部署
如果你在云端或本地算力服务器上运行,直接借助 vLLM 启动服务:
✦2. 本地 GGUF 选型与 MTP 加速
对于绝大多数本地单卡玩家,首推官方提供的 Neo-CODER MAX Dual iMatrix GGUF
普通 GGUF 在极低精度下容易丢失精度,而作者采用双重重要性矩阵(Duel iMatrix),对长文本和关键输出张量保留 16-bit 精度,让 4-bit 量化整体精度比常规 GGUF 提升 2% 到 4%
同时,官方仓库提供了带 MTP 后缀的版本(Multi-Token Prediction,多 Token 预测)
在 RTX 5090 / 4090 上,只要设置 temperature <= 1.0 且关闭重复惩罚(rep_pen = 1.0),MTP 能够以两倍 Token 的步长投机推演:
普通 Q4_K_S 量化:推理速度约 75 t/s MTP Q4_K_S 量化(命中率 60%):推理速度直接飙升至 90+ t/s
显存与硬件选型推荐:
单卡 24G 显存(RTX 3090 / 4090):直接无脑上
Q4_K_M或IQ4_XS,显存占用约 17G 左右,留足空间跑长上下文双卡 24G 或单卡 48G(A6000 / RTX 6000 Ada):推荐
Q6_K或Q8_0,体验满血 735 ARC-C 绝顶智能Mac 统一内存(M2/M3/M4 Max/Ultra,36G+ 内存):配合 llama.cpp 原生 Metal 加速,
Q5_K_M跑起来丝滑
✦总结
作为基座,Qwen3.8-27B 本身已经是国产开源之光,而这尊打着 TURBO 与 Cold Fusion 烙印的完全体,则给社区展示了顶级微调的魅力。提醒一下,这种魔改后的模型,很容易偏科,发挥十分不稳定,如果只是玩玩,那还行。如果是要生产级使用,我只建议官方版本或Unsloth量化版
优点极其鲜明:
智商硬核:735 ARC-C 与 882 ARC-E 成绩货真价实,复杂逻辑与代码理解完全跻身顶尖梯队 告别内耗:思考块大幅瘦身,不扯淡不拖沓,直接将算力转化为高浓度输出 去枷锁:ARA 任意秩消融在不破坏模型智商的前提下,还给极客完全开放的探索空间 部署亲民:消费级硬件用 Dual iMatrix GGUF 就能跑,MTP 还能直接享受 90+ t/s 的极致极速
需要留意的细节:
由于去除了过度拒答,模型默认的表达风格极为精练克制;如果你需要它生成具有高度文采、激烈情绪或者极度细致的内容,务必在 Prompt 中明确指明语气风格与关键词(它属于“给多大油门就跑多快”的引擎,你不踩油门它就保持最高效的巡航状态),另外这个版本问题蛮多,作者正在优化,出新版本