单芯片被碾压、集群反超英伟达、麒麟落后三年还卖爆——这三件事居然同时是真的
网上聊华为芯片,基本是两个极端。一边喊遥遥领先,吊打英伟达;另一边冷笑,落后十年,靠情怀续命。
两边其实都没说对。真实的华为芯片,是一个拧巴的存在:有的地方确实被按在地上摩擦,有的地方又实实在在反超了巨头,还有的地方,差距大到短期内根本没法追。
今天不站队,就把家底一条条翻出来,跟英伟达、苹果、高通、台积电挨个比。看完你就知道,以后再看到华为芯片的新闻,哪些是吹的,哪些是真的。
先盘家底:华为手里到底有哪些芯片
很多人以为华为芯片就是手机里那颗麒麟,其实麒麟只是最出名的那个。海思的产品线摊开来,是一整个货架:
昇腾:AI 算力芯片,训练大模型用的,对标英伟达
麒麟:手机处理器,对标高通骁龙、苹果 A 系列
鲲鹏:服务器 CPU,对标英特尔至强、AMD
巴龙:5G 基带芯片,这块华为一直是全球第一梯队
凌霄:路由器和物联网芯片,年出货超 3 亿颗
自研 HBM:高带宽内存,2025 年才官宣,后面细说
撑起这个货架的,是海思 1.1 万名芯片工程师,2025 年研发投入超过 200 亿,累计专利 8 万件。这个研发规模,全球能比的公司一只手数得过来。
但注意,全家桶不等于样样强。这个货架上的每样东西,水平差距非常大,得挨个看。
AI 芯片:单芯片被碾压,这个没什么好争的
先看主力昇腾 910C,2025 年量产,现在是国内 AI 算力的顶梁柱。它跟英伟达 H100 放一起比,纸面参数是这样的:
制程:中芯国际 7nm,H100 是台积电 4nm
FP16 算力:约 800 TFLOPS,H100 约 990(稠密口径)
互联带宽:约 400 GB/s,H100 的 NVLink 是 900
功耗:310W,H100 是 700W
看到规律了吗。算力、带宽这些硬指标,910C 大概是 H100 的 六到八成(各家实测口径不一),唯独功耗不到对方一半。也就是说,跑同样的活,910C 慢一些,但省电一半。
而且这还是跟 2022 年发布的 H100 比。英伟达现在的主力是 Blackwell 系列,下一代都排队了。美国外交关系委员会有个更狠的评估:美国最好的 AI 芯片大约是华为最好产品的 5 倍,到 2027 年可能拉大到 17 倍。这个算法把产能也算进去了,偏悲观,但方向没错:单芯片层面,差距是真实存在的,而且没有缩小到可以忽略的程度。
那 2026 年的新货呢?华为把原计划的 910D 砍了,直接跳到 950 系列,思路也变了。950PR 今年一季度量产,专攻推理的预填充阶段,FP4 算力 1.56 PFLOPS,大概是英伟达中国特供卡 H20 的 2.8 倍,还配了 112GB 自研 HBM。年底还有 950DT,专攻解码阶段。
但这里有个容易被宣传忽悠的点:950PR 算力是 H20 的 2.8 倍,显存带宽却只有 1.6 TB/s,H20 是 4.0。推理的解码阶段恰恰吃带宽不吃算力,所以真跑起来谁快谁慢,得看具体场景。参数表会说谎,负载不会。
华为的真正打法:一颗打不过,就三千颗一起上
单芯片输了,华为的应对方式特别耿直:堆数量,然后把互联做到极致。
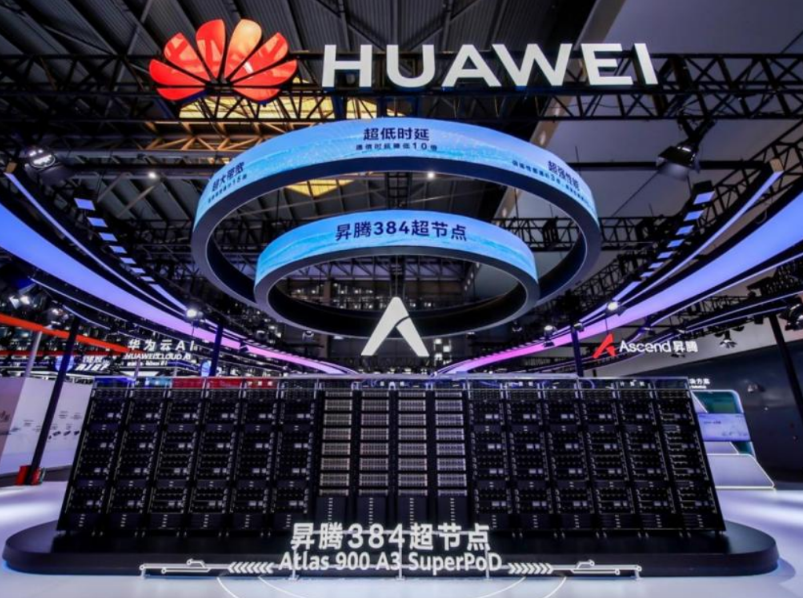
2025 年亮相的 CloudMatrix 384 超节点,把 384 颗昇腾 910C 用高速光互联拴在一起,让它们在逻辑上变成一台机器。整套系统算力约 300 PFLOPS,超过了英伟达旗舰 GB200 NVL72 的 180。这是华为第一次在系统层面反超英伟达的旗舰。
代价呢?功耗 559 千瓦,大约是英伟达那套的 4 倍。翻译成人话:芯片效率不够,拿电填。但中国恰恰不缺电,西部沙漠里有的是便宜绿电,这个交换对中国市场来说是划算的。
2026 年 7 月的世界人工智能大会上,Atlas 950 超节点真机亮相,规模直接拉到 8192 张计算卡,互联带宽 16.3 PB/s。支撑这套东西的是华为自研的灵衢互联协议,对标英伟达的 NVLink 和 AMD 主导的 UALink,芯片间通信延迟从 2 微秒压到 200 纳秒。
所以记住这个分层:单芯片,华为落后;超节点系统,华为是全球第一梯队,局部甚至领先。这不是安慰奖,训练和推理大模型本来就是集群的活,单颗芯片的强弱只是系统性能的一个输入项。
制造:最硬的那堵墙
华为所有芯片的短板,往下挖三层,都是同一个坑:造不出来。设计能力华为有,但制造在台积电手里,而华为被禁止找台积电代工,只能找中芯国际,中芯国际又买不到 EUV 光刻机。
2026 年 6 月,半导体分析机构 SemiAnalysis 的实验室把华为麒麟 9030 芯片拆了,用电子显微镜一层层看,得出一份非常有意思的报告:
中芯国际的 N+3 工艺,晶体管密度做到每平方毫米 113.4 百万颗,追平台积电 N6。注意,N6 是台积电 2021 年量产的 7 纳米级工艺,而台积电现在都量产 2 纳米了。
更魔幻的是,N+3 有个金属间距指标 32.5 纳米,比英特尔最新的 18A 工艺还小。但这是拿四重曝光硬堆出来的,光罩多、良率难控、成本高,属于用十倍的辛苦换八成的效果。
一句话总结制造环节:没有 EUV,中芯用老设备硬生生摸到了别人五年前的水平,但每往前一步的代价都在指数级上涨。制程实质落后两到三代,这是华为芯片所有性能差距的总根源。
华为当然知道这堵墙短期翻不过去,所以换了条路,叫韬定律:既然晶体管没法继续缩小,那就往立体发展。最新的麒麟 9050 Pro 已经落地第一代逻辑折叠技术,把电路上下两层堆叠,相当于把平房改成复式楼房,单代晶体管密度提升超 50%。按华为的路线图,实验室样片已经跑通 3.39GHz,目标 2031 年冲 5GHz。
另一块被卡的死死的配套是 HBM 高带宽内存。全球只有 SK 海力士、三星、美光三家能造,全都被禁售。华为 2025 年官宣自研,分 HiBL 和 HiZQ 两代,自建产线。目前带宽只有 1.6 TB/s,相当于别人 HBM2e 的水平,落后最新 HBM3e 一大截。但意义在于:从逻辑芯片到内存到封装到互联协议,整条 AI 芯片产业链,华为第一次全部握在自己手里。慢,但断不了粮。
手机芯片:性能落后三年,生意却好到爆
还是那份 SemiAnalysis 拆解报告,麒麟 9030 的成绩单相当扎心:
CPU 大核的性能,单看每时钟周期效率,大概相当于 ARM 家 2021 年的 Cortex-X2。苹果 2020 年 M1 芯片的核心还比它高 35%。GPU 经过大幅升级后,追平了苹果 A16,也就是 2022 年的旗舰水平,跟现在的高通骁龙 8 Elite 比还慢 2.4 到 3.7 倍。
按 2026 年的标准,麒麟 9030 就是一颗中端芯片。性能落后当代旗舰三年,这是事实。
但另一个事实是:首发麒麟 9030 Pro 的 Mate 80 Pro Max,开卖 18 天销量破 100 万台。
这两个事实放一起,说明一个挺反直觉的事:对绝大多数用户来说,2022 年的旗舰性能日常使用完全够用,拍照、微信、打游戏都流畅。手机不是跑分仪,用户买的是整机体验、卫星通信和鸿蒙生态,芯片只是其中一环。性能落后但体验不拉胯,生意就能继续做。
当然也别过度美化。游戏党、重度用户对这颗芯片的极限是有感知的,华为自己也在拼命用架构创新补制程,9050 Pro 的逻辑折叠就是第一招。但只要 EUV 进不来,手机芯片就只能在别人身后两年到三年的位置跟着跑,这个差距短期内无解。
软件生态:比硬件更难啃的骨头
如果只看跑分,你可能会觉得华为离英伟达没那么远。真正远的,是 CUDA。
英伟达的 CUDA 生态积累了快二十年,全球几十万 AI 开发者的代码、习惯、工具链全长在上面。华为的对标物叫 CANN,目前适配了超过 1000 个主流模型,看着不少,但跟 CUDA 的生态体量比还差着数量级。
这件事的麻烦在于,它不是砸钱能快速解决的。一家公司要从 CUDA 迁到 CANN,意味着重写代码、重新调优、重训工程师,出了问题还没有 Stack Overflow 上现成的答案。所以很多公司宁可买贵三倍的英伟达,也不敢赌。
转机来自两个方向。一是推理需求爆发后,模型部署环节的软件复杂度比训练低得多,CANN 的短板没那么致命;二是标杆客户开始迁移,DeepSeek 已经把底层框架从 CUDA 全栈迁到了 CANN Next,这是第一个这么干的大模型厂商,示范效应很大。
但说到底,生态这场仗华为才刚开始打,硬件差距是可以量化到年的,生态差距可能是十年起步。
市场结果:国内已经翻盘了
技术聊完,看真金白银投出来的结果,这里的变化是最剧烈的。
2024 年之前,英伟达在中国 AI 芯片市场的份额接近 95%,接近垄断。摩根士丹利 2026 年 5 月的研报预测:今年华为昇腾份额 62%,寒武纪 14%,英伟达掉到 8%。黄仁勋自己在 4 月份的采访里说,英伟达在中国的份额已经归零。
三年时间,五分之四的市场易主。原因不复杂:美国管制把 H100、B200 全禁了,特供的 H20 又一再阉割,采购方被逼着换国产;推理需求爆发后大家开始算性价比账,昇腾的推理方案反而划算;再加上政策要求,三大运营商和互联网大厂的订单系统性转向昇腾。
但要泼一盆冷水:这只是中国市场。放眼全球,英伟达依然拿走九成以上的 AI 芯片市场,华为在海外几乎卖不动 AI 芯片。而且国内这个 62% 的份额,一半靠产品力,一半靠管制送助攻。英伟达要是哪天被放回来了,仗还得重新打。当然,从 2026 年的形势看,放回来的可能性越来越小了。
最后,给华为芯片打个分
把上面所有信息压成一张评分卡,跟各家巨头逐项对比:
芯片设计能力:一流。能同时设计 AI 芯片、手机 SoC、服务器 CPU、基带的公司,全球独一份。设计的下限由制造决定,不由脑子决定。
制造工艺:落后两到三代。约等于台积电 2021 年水平,这是跟台积电、ASML 的差距,板子不全打在华为身上。
单芯片性能:英伟达的四到七成。看口径,跑分口径更惨,实测口径好一些。
系统级算力:第一梯队,局部领先。超节点和互联是真功夫,用电换来的也是真算力。
手机芯片:落后旗舰三年。但配合整机体验和生态,商业上活得很健康。
软件生态:差距最大的一项。十年起步的差距,正在靠推理场景和标杆客户慢慢磨。
市场:国内赢家,海外缺席。
所以华为芯片到底是什么水平?我的答案是:一家被掐住了制造咽喉的一流芯片设计公司,靠系统工程和便宜的电,在自家市场打赢了巨头,但在全球最尖端的战场上,依然隔着几代人的距离。
华为证明了封锁杀不死一家拥有完整工程师体系和充足现金流的公司。但同时它也证明了,先进制程那堵墙是真的高,绕路的代价是真的贵。
以后再看华为芯片的新闻,记住三个口径就行:纸面峰值、实测性能、集群系统。发布会用的是第一个,采购方看的是第二个,华为真正翻盘靠的是第三个。谁能同时把这三件事说清楚,谁就没被带节奏。
数据来源:SemiAnalysis STEEL 实验室拆解报告(2026 年 6 月)、摩根士丹利与伯恩斯坦研报、华为全联接大会及 WAIC 2026 公开资料。文中产能与良率数据为行业分析口径,未经官方确认。