上一篇
7阶段37条要求!AI出事谁担责?一图读懂网安标委AI安全新指引
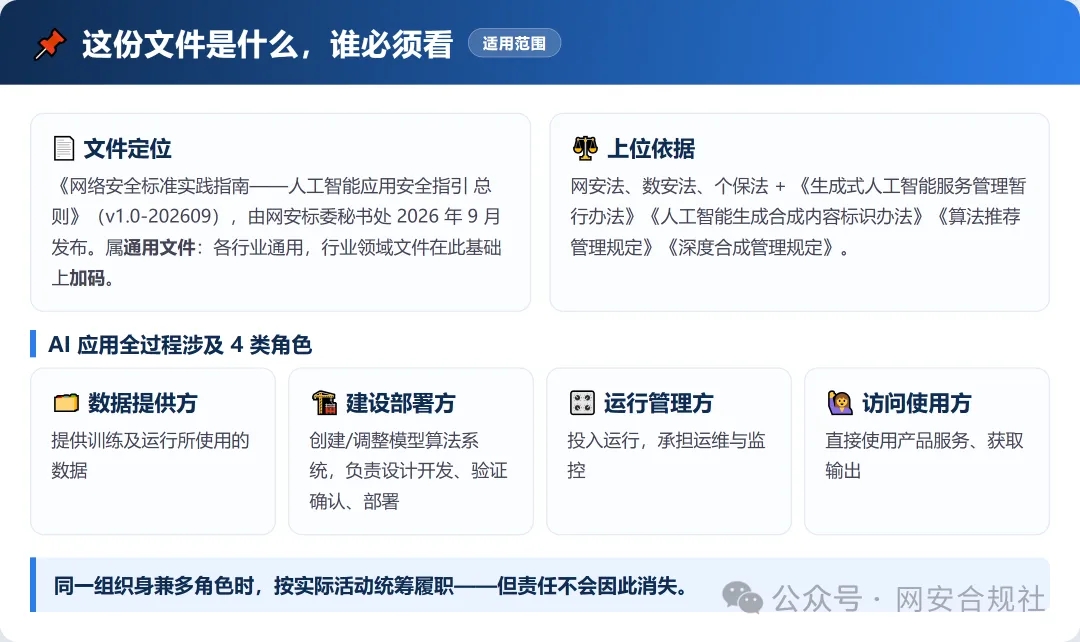
2026 年 9 月,全国网络安全标准化技术委员会(网安标委)发布《网络安全标准实践指南——人工智能应用安全指引 总则》(TC260-PG-20268A,v1.0-202609)。如果说之前发布的《个人用户使用人工智能服务安全指南》是写给咱们普通人的,那这份新文件,就是写给所有正在「上 AI」的单位的。
一句话概括:不管你是自研大模型、基于开源二次开发,还是采购第三方 AI 服务接入业务,从立项规划到最终下线,7 个阶段、37 条安全要求,这份文件都给你划好了线。
AI 上线不是「能跑就行」,而是「能停、能查、能赔」。这是全文最核心的一句话。
一、先搞清楚:出了事,谁担责?
文件把 AI 应用全过程拆成了 4 类角色:数据提供方(提供训练和运行数据)、建设部署方(做模型、做系统、做部署)、运行管理方(负责上线后的运维监控)、访问使用方(直接用 AI 干活的)。同一个组织可以身兼多角,但责任不会因此消失——每一类的安全职责都要落到位。
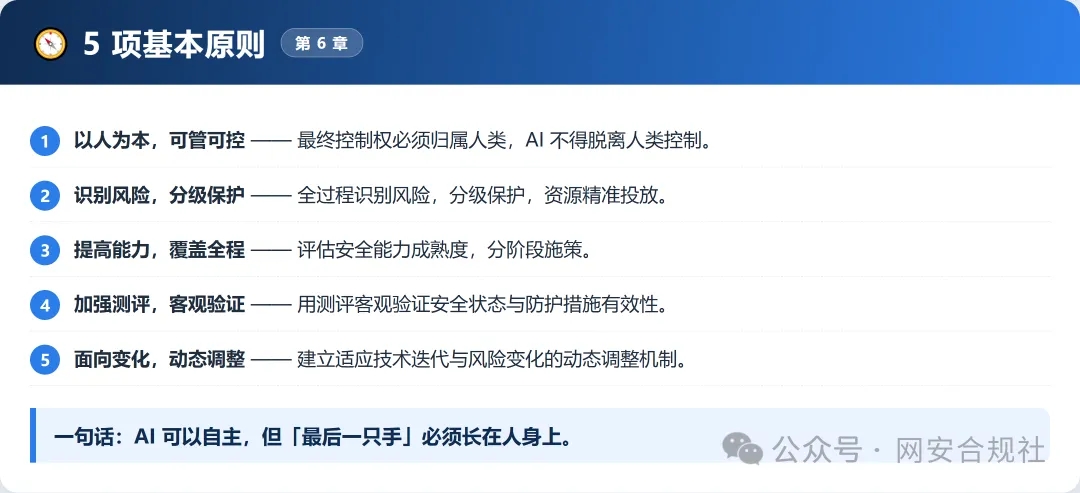
在此基础上,文件提出 5 项基本原则,可以当成企业 AI 安全治理的「总纲领」:
二、7 个阶段怎么走?一张图看懂
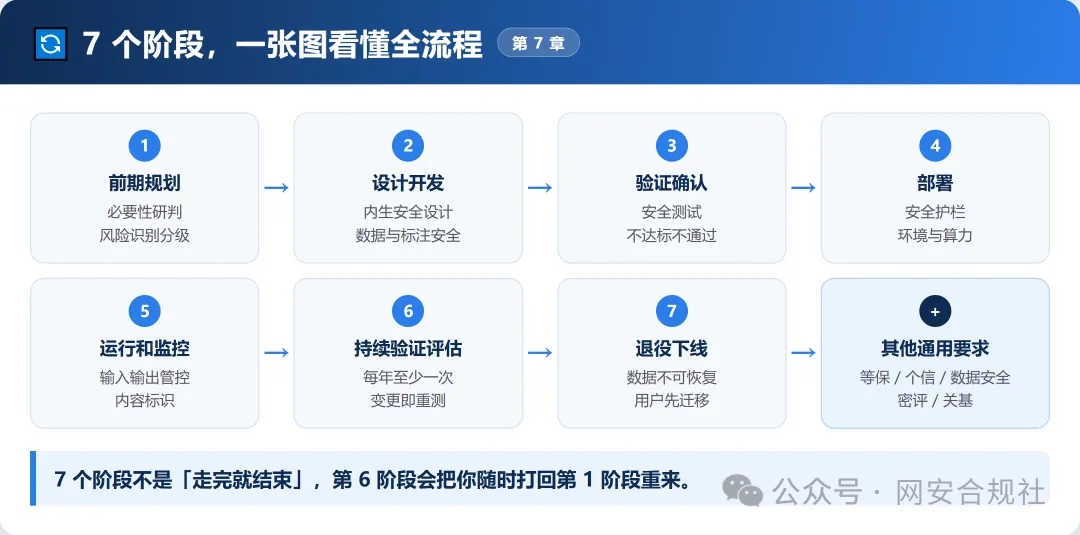
这是文件的主体框架,和软件工程里的 SDLC(软件开发生命周期)高度对应:前期规划 → 设计开发 → 验证确认 → 部署 → 运行和监控 → 持续验证评估 → 退役下线。另外还有一节「其他」要求,把等保、个人信息保护、数据安全、密码应用、关基保护这五条并行合规线全部拉了进来。
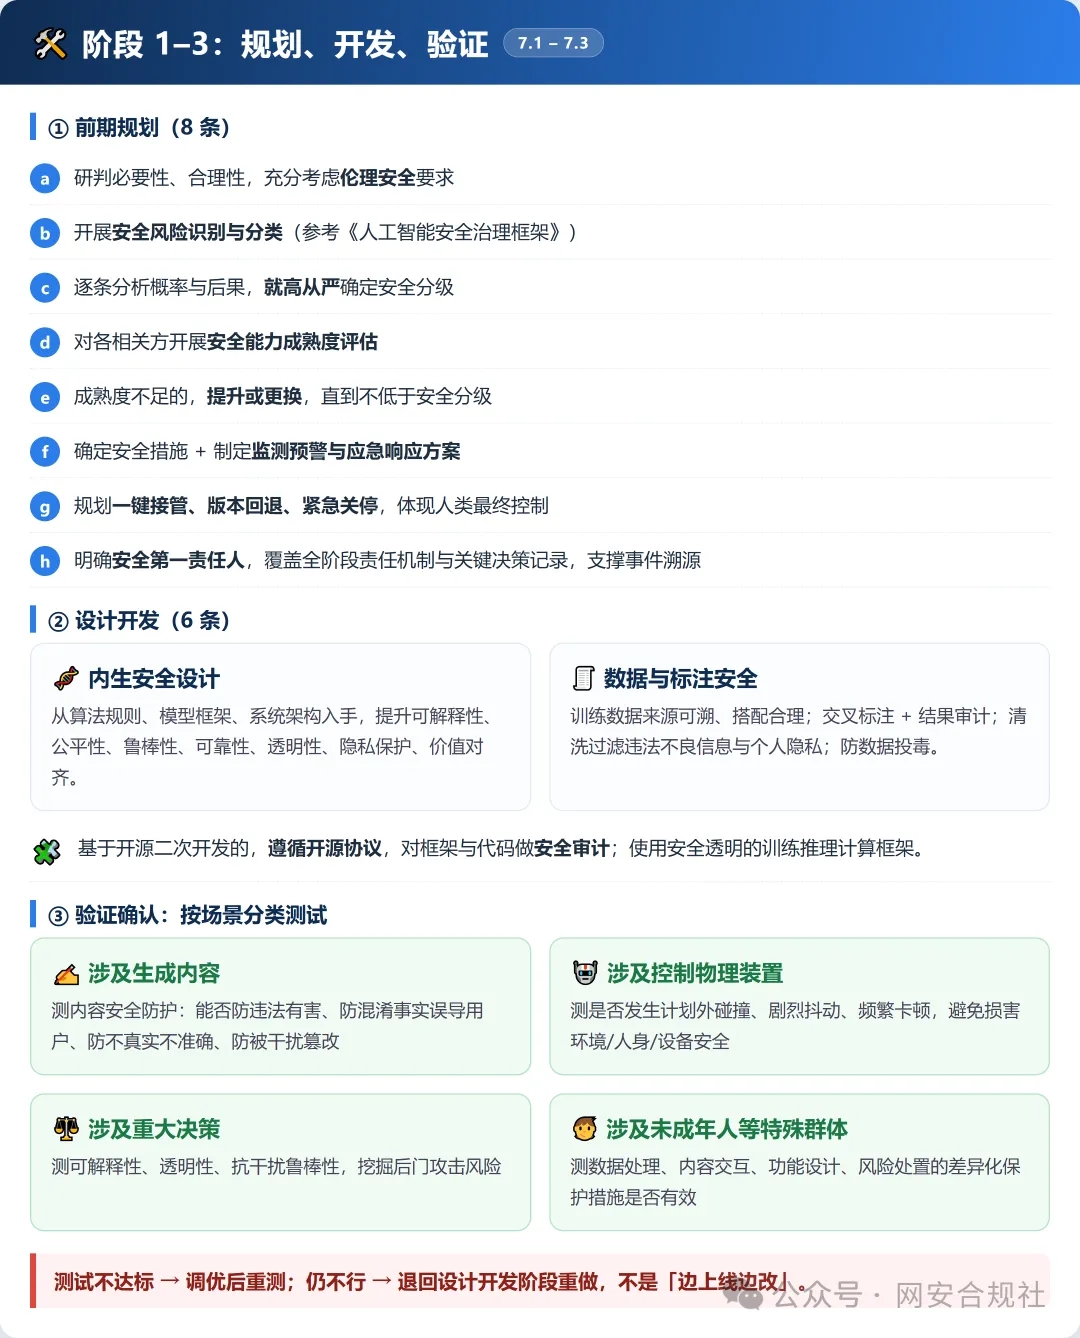
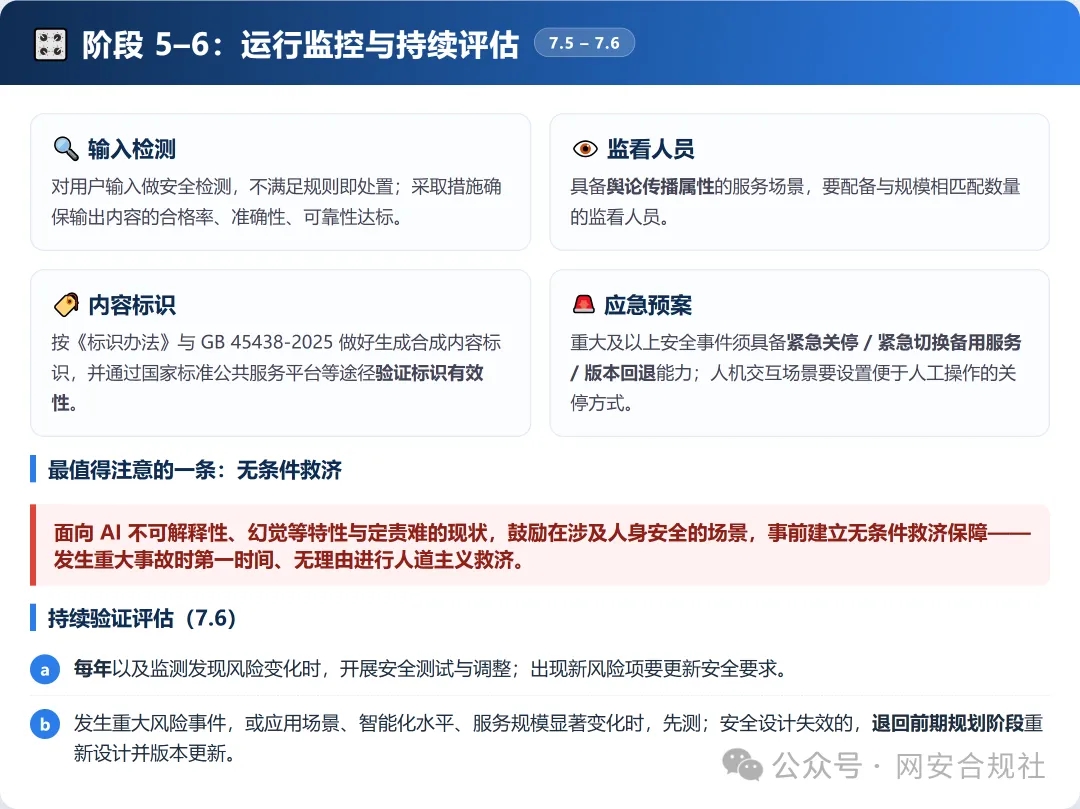
特别注意第 6 阶段:每年至少开展一次安全测试,出现重大风险事件、或应用场景/智能化水平/服务规模显著变化时,安全设计失效的会被「打回」前期规划阶段重新设计。
三、风险分五级,能力要「够格」
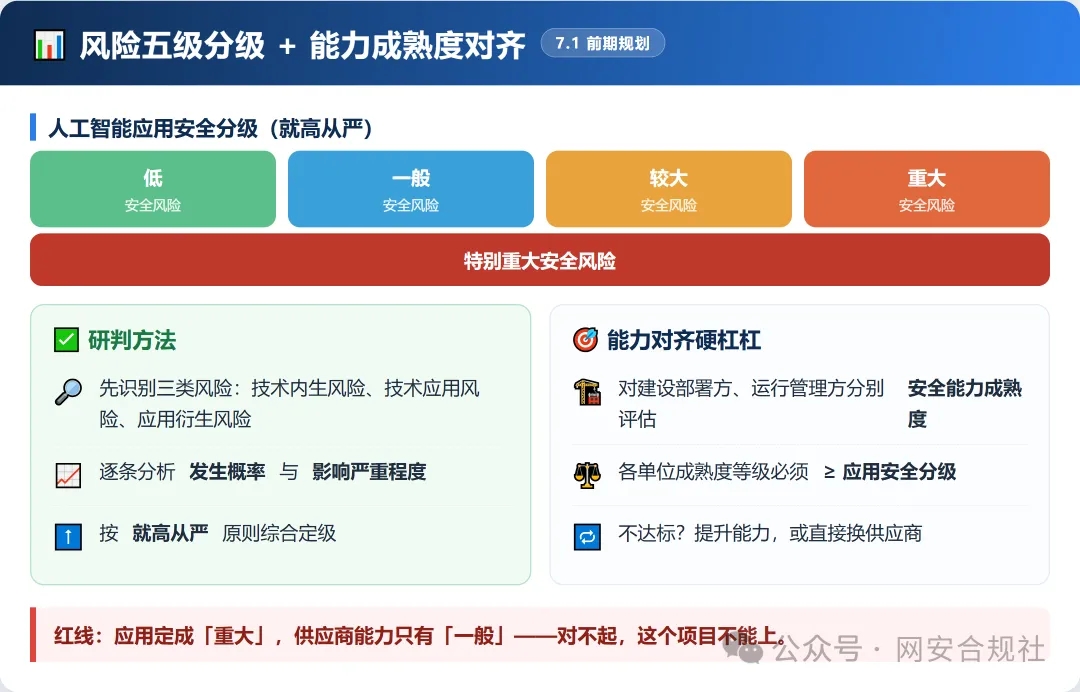
前期规划阶段有个很「硬核」的机制:安全分级 + 能力对齐。
同时还要明确安全第一责任人,建立覆盖全阶段的安全责任机制,模型选型、数据源选取、部署方式选择等关键决策都要有记录,出事能追溯到人。
四、开发到上线前:三条硬门槛
设计开发阶段,重点抓两头:一头是内生安全——从算法规则、模型框架、系统架构入手,提升可解释性、公平性、鲁棒性、可靠性、透明性、隐私保护和价值对齐;另一头是数据安全——训练数据来源可溯、交叉标注加结果审计、清洗过滤违法不良信息和个人隐私信息、防止数据投毒。基于开源二次开发的,还得遵循开源协议并对框架代码做安全审计。
验证确认阶段最务实的一点:按应用场景分类测试——
测试不达标:能调优解决的,调优后重测;解决不了的,退回设计开发重做——不是「边上线边改」。
五、部署:四类环境,四套打法
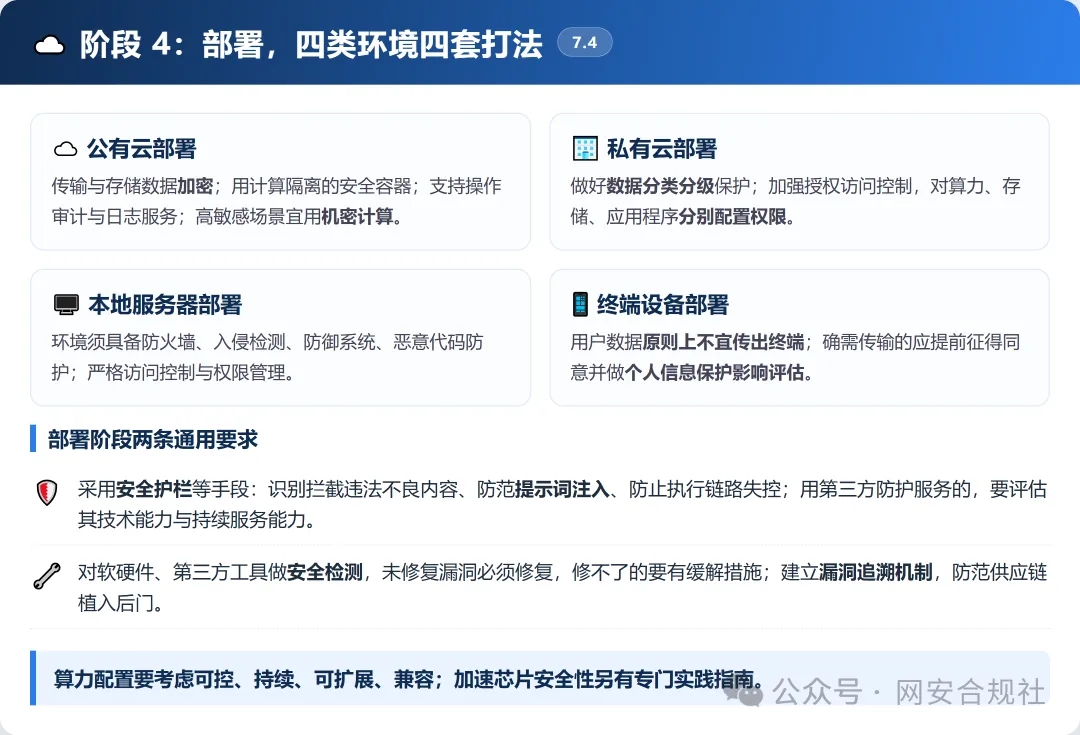
部署阶段给出了很接地气的分环境指引:
通用要求两条:一是部署安全护栏,拦截违法不良内容、防提示词注入、防执行链路失控;二是对软硬件和第三方工具做安全检测,建立漏洞追溯机制,防范供应链植入后门。
六、跑起来之后:监控、标识、能「一键关停」
运行和监控阶段,几个动作是硬性的:用户输入要做安全检测;具备舆论传播属性的服务场景,要配备与服务规模相匹配的监看人员;生成合成内容要按《人工智能生成合成内容标识办法》和 GB 45438-2025 做好标识,并通过国家标准公共服务平台验证标识有效性。
应急方面,针对重大及以上安全事件,必须具备紧急关停、紧急切换备用服务、版本回退能力;涉及人与物理空间交互的场景,要设置便于人工操作的关停方式,防止失控时停不下来。
全文最值得关注的一条:鉴于 AI 的不可解释性、幻觉等技术特点和「定责难」的现状,文件鼓励在涉及人身安全的应用场景,事前建立无条件救济保障措施——发生重大事故时,第一时间、无理由进行人道主义救济。
「无条件救济」写入官方指引文件,等于给 AI 应用的责任兜底提供了新思路:先赔人、后定责。
七、下线也不能「一关了之」
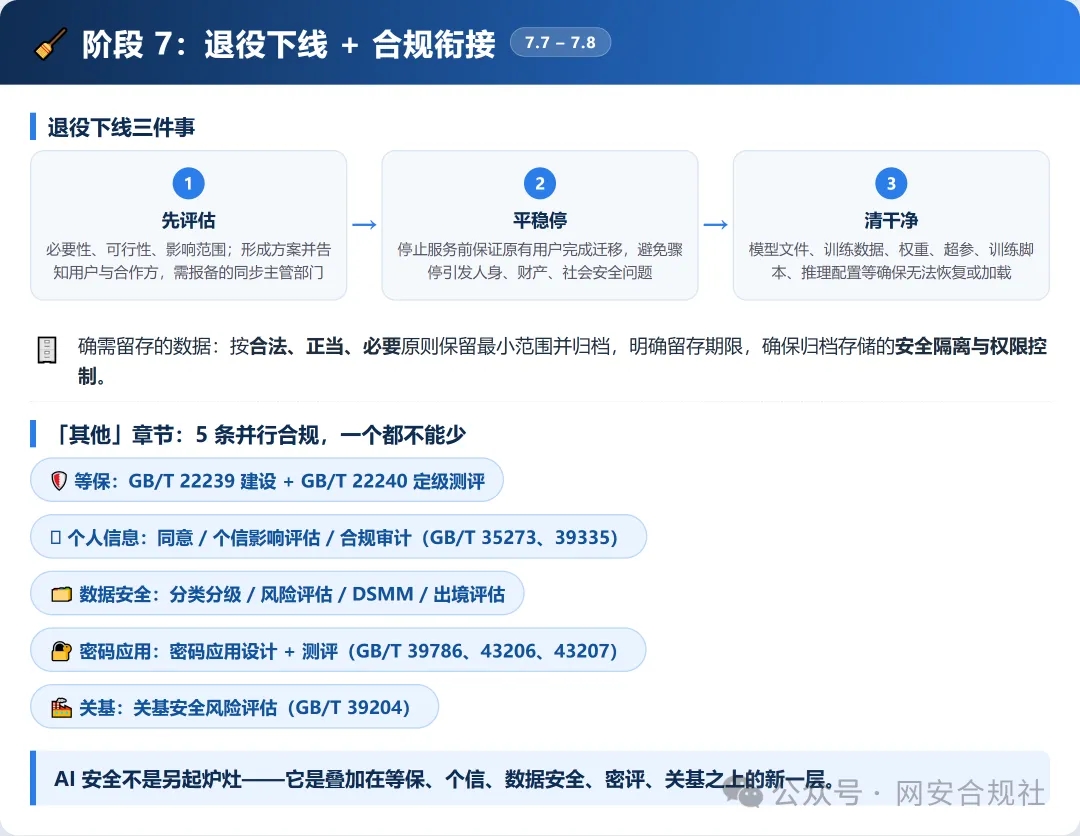
退役下线阶段分三步:先做必要性、可行性、影响范围的安全评估并形成方案,告知用户和合作方(需报备的主管部门也要同步);停止服务前保证原有用户完成迁移,避免骤停引发人身、财产、社会安全问题;最后是数据清理——模型文件、训练数据、权重文件、超参数配置、训练脚本、推理服务配置等,都要确保无法被恢复或加载。确需留存的,按合法、正当、必要原则保留最小范围,明确期限,隔离存储、控制权限。
「其他」章节则把 AI 安全和其他合规体系做了衔接,五条并行要求一个都不能少:等保(GB/T 22239/22240)、个人信息保护(同意、影响评估、合规审计)、数据安全(分类分级、风险评估、出境评估)、密码应用(GB/T 39786 等)、关基保护(GB/T 39204)。
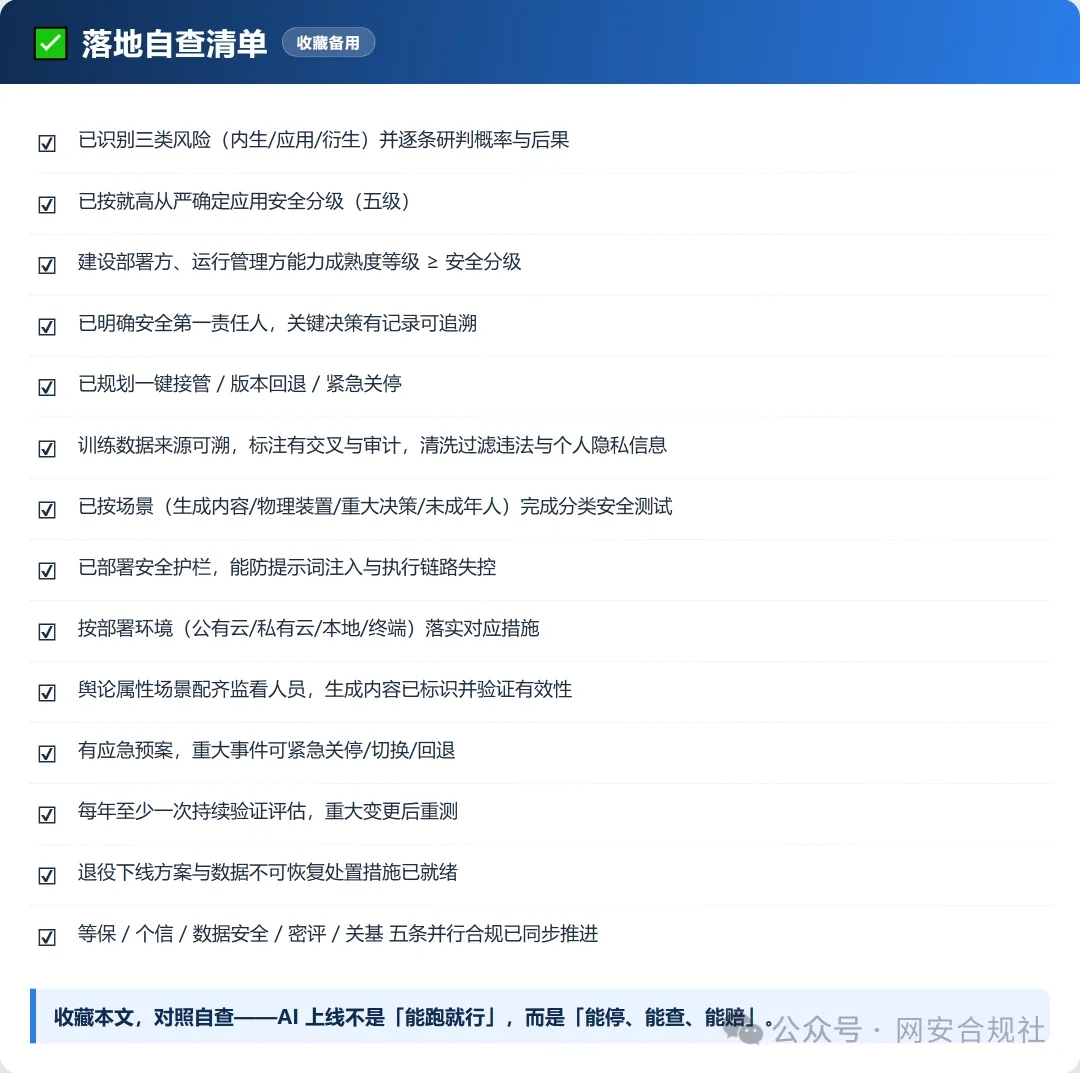
八、给你的落地自查清单
最后送上一份 14 项自查清单,建议对照自己的 AI 项目逐项打勾:
三个常见问题:
Q:我们只是采购第三方大模型 API,也适用吗?
A:适用。作为「访问使用方」或「运行管理方」,至少要在选型评估、运行监控、应急关停、数据出终端等环节落实对应要求。
Q:内部试用、不面向公众的 AI 项目要做吗?
A:文件适用于各行业领域组织开展 AI 应用的安全风险防范与管理,不限于对公众提供服务;涉及重大决策、物理装置、人身安全的内部应用,风险等级反而更高。
Q:和等保测评冲突吗?
A:不冲突,是叠加关系。文件明确要求按等保开展系统安全建设和测评,AI 安全要求是在等保、个信、数据安全、密评基础上的新增一层。
AI 已经从「要不要用」进入「怎么安全地用」的阶段。这份总则就是官方给出的第一份全生命周期底线清单,后续各行业的领域文件也会陆续跟进。建议政企单位尽早对照自查,别等监管问询时才补作业。
来源:全国网络安全标准化技术委员会秘书处《网络安全标准实践指南——人工智能应用安全指引 总则》(TC260-PG-20268A,v1.0-202609)。本文为通俗解读,具体要求以原文为准。
觉得有用,转发给你身边正在做 AI 项目的朋友。关注「网安合规社」,第一时间获取网络安全与数据合规的最新解读。
https://mp.weixin.qq.com/s/SS9c2XiSUN7G4vBq6f6wlg