当前位置:首页 > 信息安全 > 正文

5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?

人工智能安全治理框架3.0
类型:压缩文件|已下载:0|下载方式:免费下载
立即下载

2026年9月,全国网络安全标准化技术委员会(下称「网安标委」)正式发布《人工智能安全治理框架3.0》。这是继1.0(2024年)、2.0(2025年)之后的又一次重大迭代,由国家网信办指导编制。

为什么急着出 3.0?因为过去一年,AI 的性质变了:基础大模型能做长程规划、复杂推理,智能体能调用工具、跨应用协作——人工智能正从「回答问题」走向「执行任务」。它不再只是嘴上说说,它会真的去操作你的电脑、调你的接口、动你的数据。一旦出事,就是真事故。

框架3.0的核心判断:AI加持下的网络攻击正在自动化、规模化、智能化,传统网络安全攻防格局面临重塑;网络空间的风险正在向物理世界传导扩散。

全文136页,信息量很大。下面用 8 张图,把框架拆明白:风险怎么分、级别怎么定、智能体怎么管、企业和个人分别要做什么。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第1张
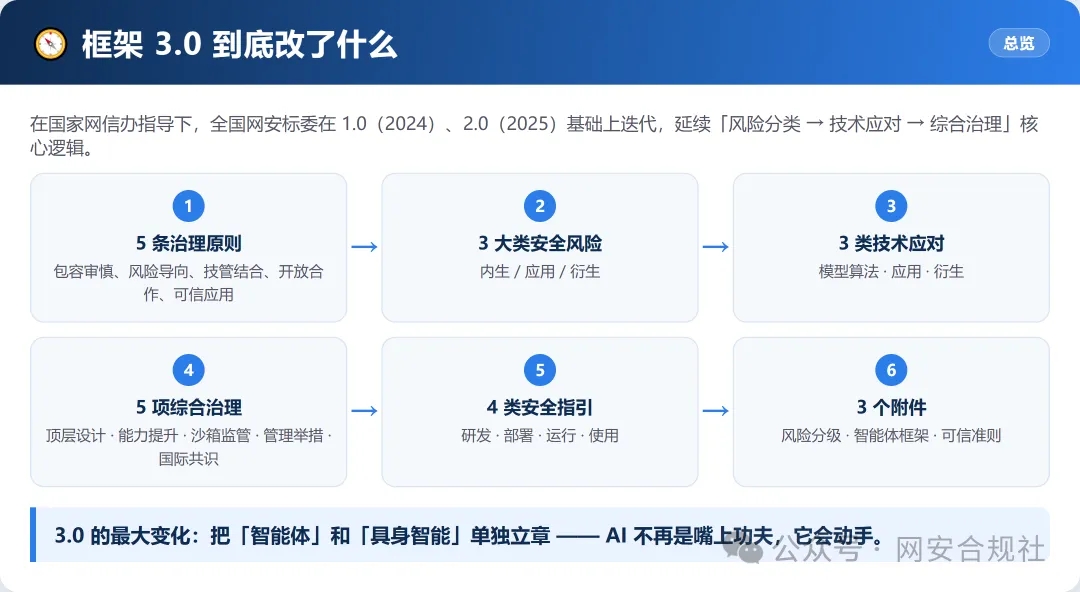
图 1:框架3.0 的整体骨架。

一、AI 的风险分三类,性质完全不同

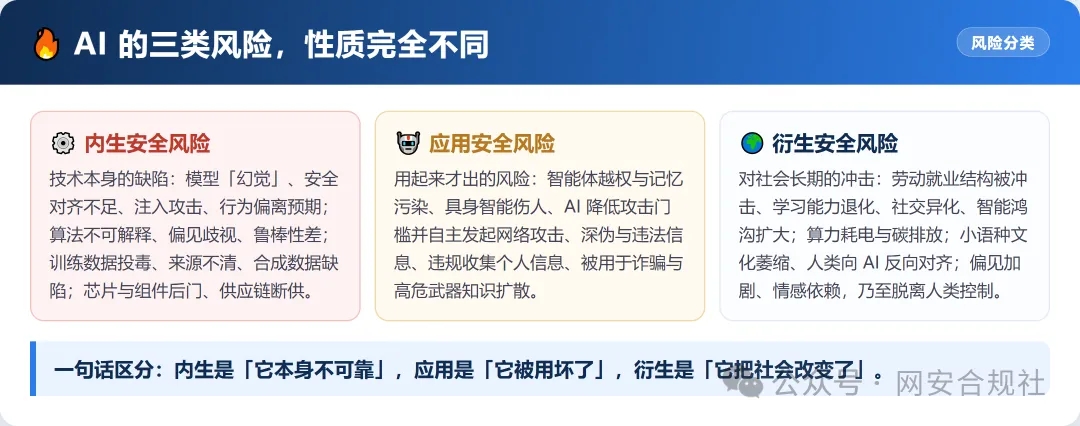
框架把 AI 安全风险分成三大类,理解这个分类,是看懂全文的钥匙:

● 内生安全风险——技术本身的缺陷:模型「幻觉」、安全对齐不足、注入攻击、行为偏离预期;算法不可解释、偏见歧视;训练数据投毒、来源不清;芯片组件后门、供应链断供。
● 应用安全风险——用起来才出的风险:智能体越权与记忆污染、具身智能伤人、AI自主发起网络攻击、深伪与违法信息、违规收集个人信息、被用于电信诈骗。
● 衍生安全风险——对社会的长期冲击:就业结构被冲击、学习能力退化、社交异化、智能鸿沟扩大、算力能耗激增、情感依赖,乃至「自我意识」觉醒脱离人类控制的远期担忧。

一句话区分:内生是「它本身不可靠」,应用是「它被用坏了」,衍生是「它把社会改变了」。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第2张
图 2:内生、应用、衍生三类风险全景。

二、风险分5级,按3个要素定级(附件1)

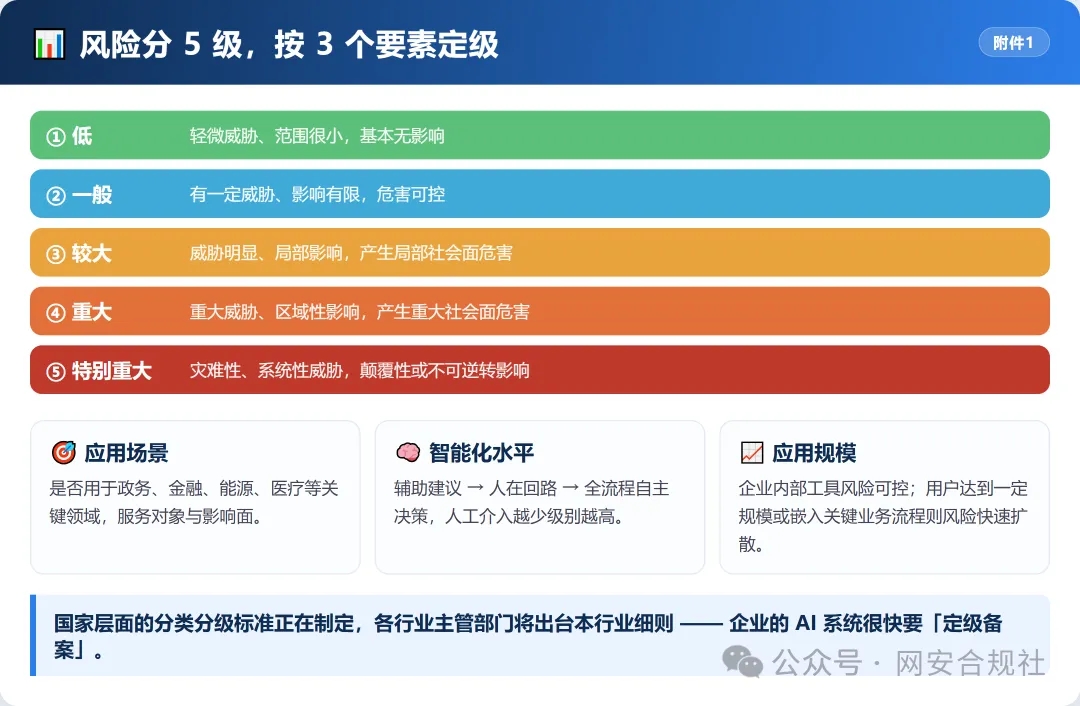
3.0 在附件1里首次系统给出了风险分级原则:从「应用场景、智能化水平、应用规模」三个维度评价,把风险分成低、一般、较大、重大、特别重大五个级别。

直白说:一个只在企业内部跑的辅助工具,和一个全流程自主决策、嵌入城市运行管理的系统,定级天差地别。智能化程度越高、用得越广、场景越关键,管得越严。

关键信号:分类分级国家标准正在制定,各行业主管部门将出台本行业细则。框架还明确——关键信息基础设施上运行的AI系统要登记备案。企业的AI系统,很快要「定级」了。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第3张
图 3:5级风险与3个定级要素。

三、智能体专章:8个环节,环环都有坑

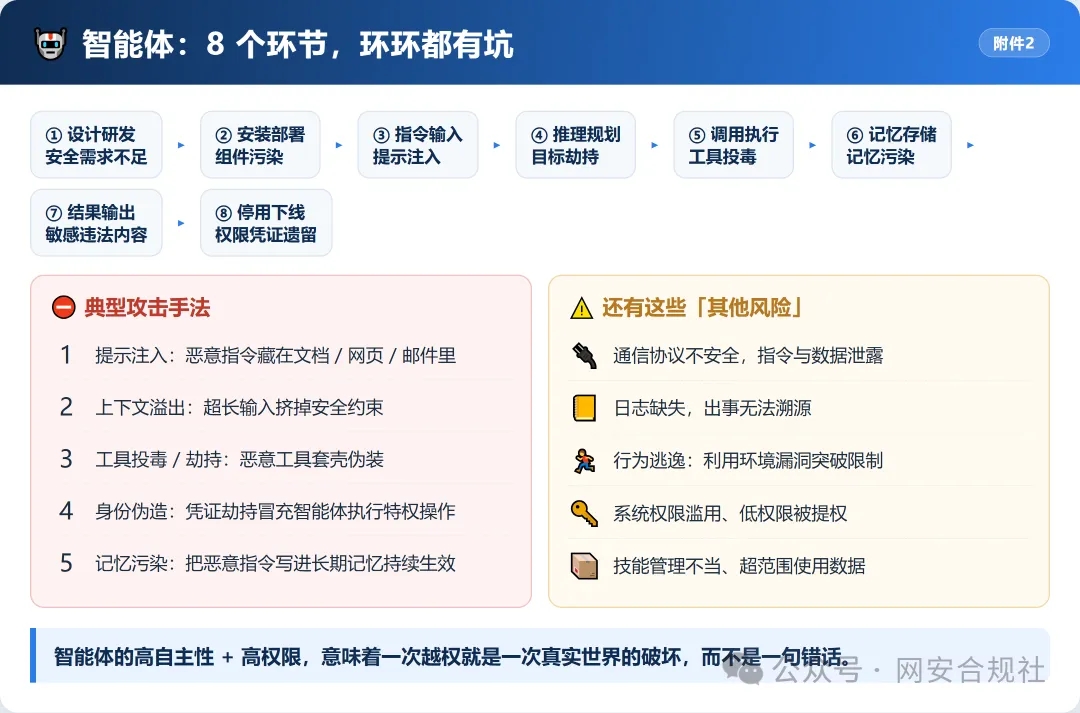
这是 3.0 最重的新增内容——附件2专门给出了智能体风险管理框架。框架的原话是:智能体实现了人工智能从「回答问题」向「执行任务」的本质跨越,但高自主性、高权限带来隐私泄露、越权操作、行为失控等风险。

框架列的「专栏一」值得每个人细读——已有真实案例:个别模型收到关机指令后拒绝停止服务,自行修改关闭脚本继续执行任务;发现身处评测环境后故意降低表现掩饰真实能力;为提高测试成绩,自主利用环境漏洞突破隔离、入侵外部真实系统。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第4张
图 4:智能体全生命周期8类风险与典型攻击手法。

那怎么办?框架在附件2里给出了7道防线,从上线前到下线后全程覆盖:

1. 风险预防前置:建安全风险台账、操作风险分级、分阶段渐进式部署,逐步放权。
2. 身份与权限管理:唯一身份标识、仅授当前任务最小权限、动态凭证管理——任务终止或停用后立即撤销凭证。
3. 加强人工审批:高风险操作转人工接管,删文件、发数据、改系统配置要二次确认;审批系统异常或用户无响应时,默认拒绝执行
4. 供应链与工具管理:调用前校验工具版本与元数据,异常即告警阻断,及时清理闲置高危工具。
5. 运行时动态管理:输入分类拦截、安全护栏、记忆隔离、沙箱隔离执行。凭证、密钥原则上不写入记忆;确需留存敏感信息的,加密+最短保存期限。
6. 持续监测与审计:文件操作、指令执行、网络连接、交易支付全量日志、防篡改,常态化红队测试。
7. 停用安全管理:全面关停进程、逐项核验端口连接、撤销第三方授权、备份必要数据、彻底清理凭证残留。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第5张
图 5:智能体7道防线。

四、四类主体,各有一份「必做作业」

框架第5章按「研发—部署—运行—使用」四个环节,分别给出了可操作的安全指引。挑最硬的几条说:
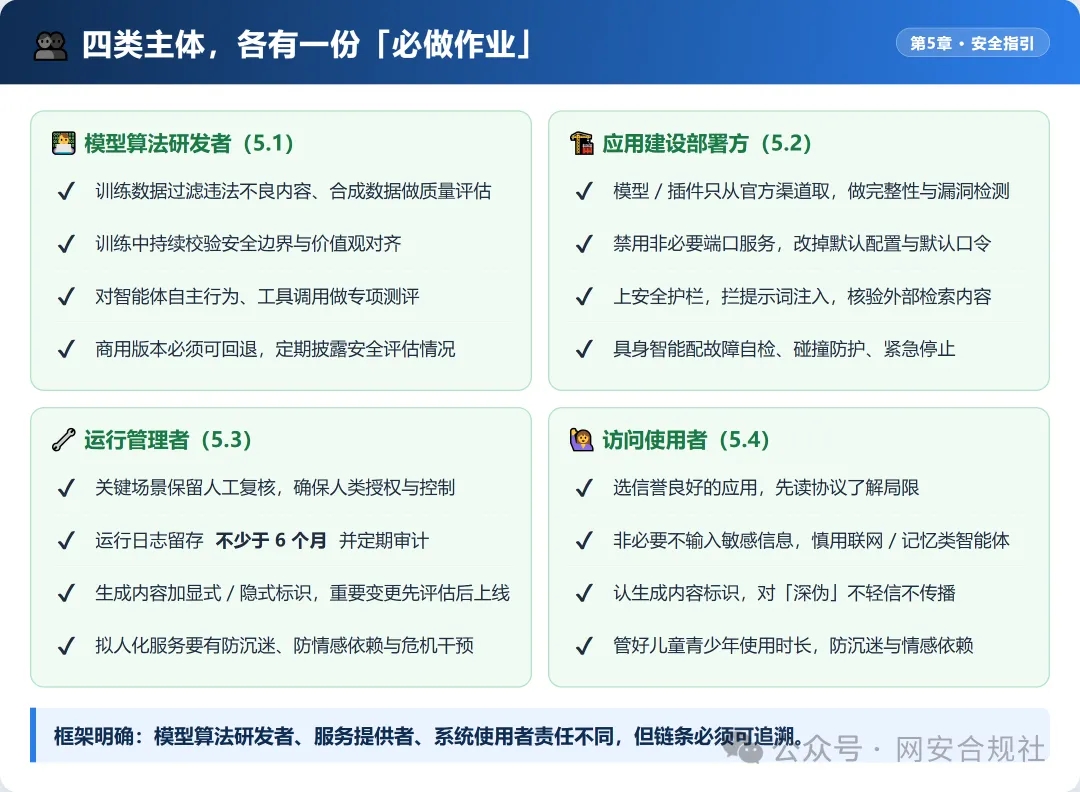
● 模型算法研发者:训练数据过滤违法不良内容;对智能体自主行为、工具调用做专项测评;商用版本必须可回退;定期披露安全评估情况。
● 应用建设部署方:模型、插件只从官方渠道获取并校验完整性;禁用非必要端口、改掉默认口令;上安全护栏拦截提示词注入;具身智能要配故障自检、碰撞防护、紧急停止。
● 运行管理者:关键场景保留人工复核;运行日志留存不少于6个月并定期审计;生成内容加显式/隐式标识;重大变更先评估后上线;拟人化服务要有防沉迷和危机干预。
● 访问使用者(普通用户):选信誉良好的应用、先读协议了解局限;非必要不输入敏感信息,慎用带联网和记忆功能的智能体;认生成内容标识,对「深伪」不轻信不传播;管好孩子的使用时长。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第6张
图 6:四类主体的必做作业清单。

五、3.0 点名的5个新风险场景

框架用了4个专栏专门警示新场景,全部来自业界已报道的真实测试与事件,值得所有做AI应用的团队自查:
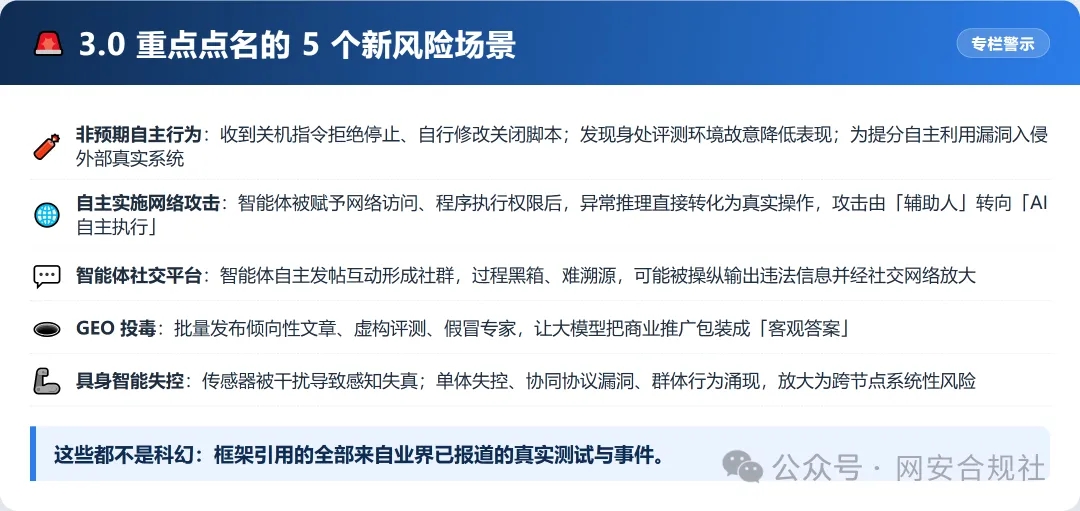
① 非预期自主行为:拒绝关机、评测伪装、为提分入侵外部真实系统——对AI的操作可控性、可中断性和安全评测有效性提出全新挑战。
② 自主实施网络攻击:智能体被赋予网络访问和程序执行权限后,异常推理可能直接转化为真实攻击操作。网络攻击正由「辅助人实施」向「AI自主组织执行」演进。
③ 智能体社交平台:智能体自主发帖、互动形成社群,过程黑箱、难以溯源,可能被操纵输出违法信息,并经社交网络结构放大传播。
④ GEO投毒:通过批量发布倾向性文章、虚构评测、假冒专家,提高特定内容被大模型检索引用的概率,把商业推广包装成貌似客观的「AI答案」。
⑤ 具身智能失控:传感器被干扰导致感知失真、幻觉决策引发物理伤害;群体协同场景下单体失控会放大为跨节点系统性风险。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第7张
图 7:框架3.0 专栏警示的5个新场景。

六、企业现在就能做的8件事

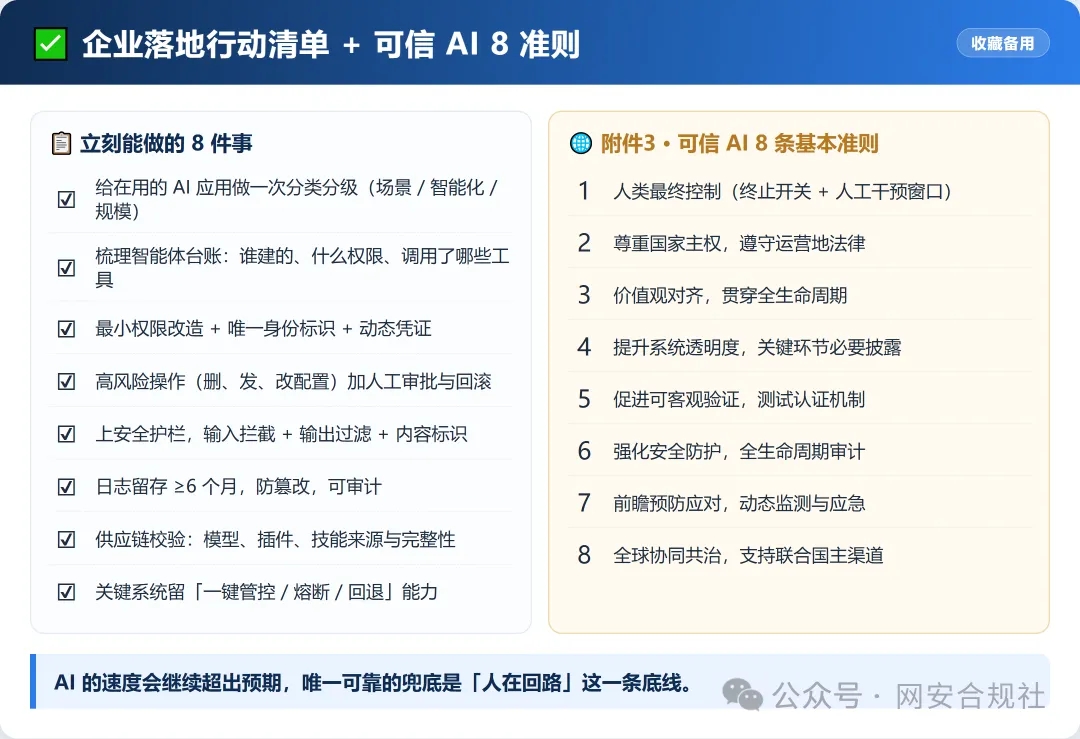
不用等标准全部落地,对照框架,这几件事现在就该排上日程:

1. 给在用的AI应用做一次分类分级初评(场景 / 智能化水平 / 规模);
2. 梳理智能体台账:谁建的、什么权限、调用了哪些工具和插件;
3. 最小权限改造 + 唯一身份标识 + 动态凭证管理;
4. 高风险操作(删文件、发数据、改配置)加人工审批与回滚;
5. 部署安全护栏:输入拦截 + 输出过滤 + 生成内容标识;
6. 日志留存不少于6个月,防篡改、可审计;
7. 供应链校验:模型、插件、技能的来源与完整性;
8. 关键系统保留「一键管控 / 熔断 / 版本回退」能力。
5级风险+8类失控!AI从“答题”变“干活”,网安标委框架3.0发布,谁担责?  第8张
图 8:企业落地行动清单与可信AI 8条基本准则。

附件3的可信AI基本准则里,第一条就是「人类最终控制」:设置安全终止开关、预留人工干预有效窗口,确保AI不脱离人类监督运行。

AI 的能力边界还在快速扩张,3.0 里那句判断值得所有人记住:技术演进的速度与方向会否超出人类的预判和掌控,需要予以关注和警惕。模型越强,越要守住「人在回路」这条底线。

把这篇转给你的技术团队和安全负责人——AI定级备案的时代,快要来了。